
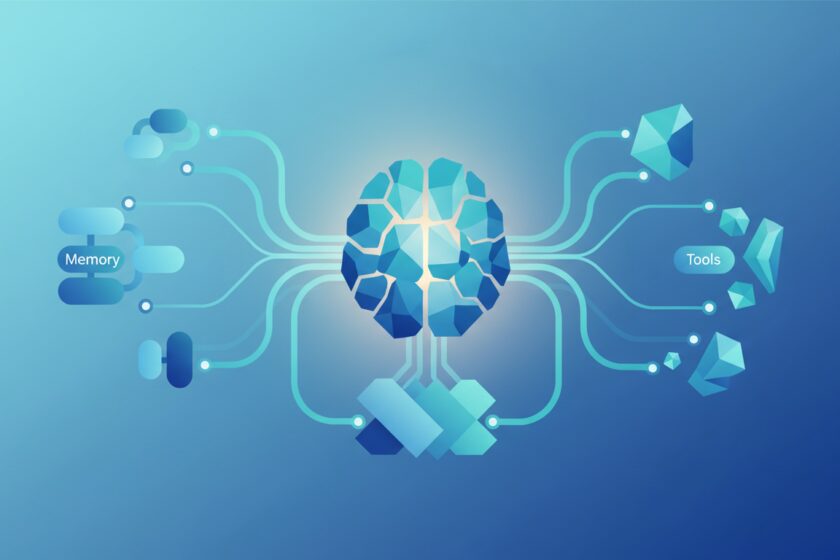
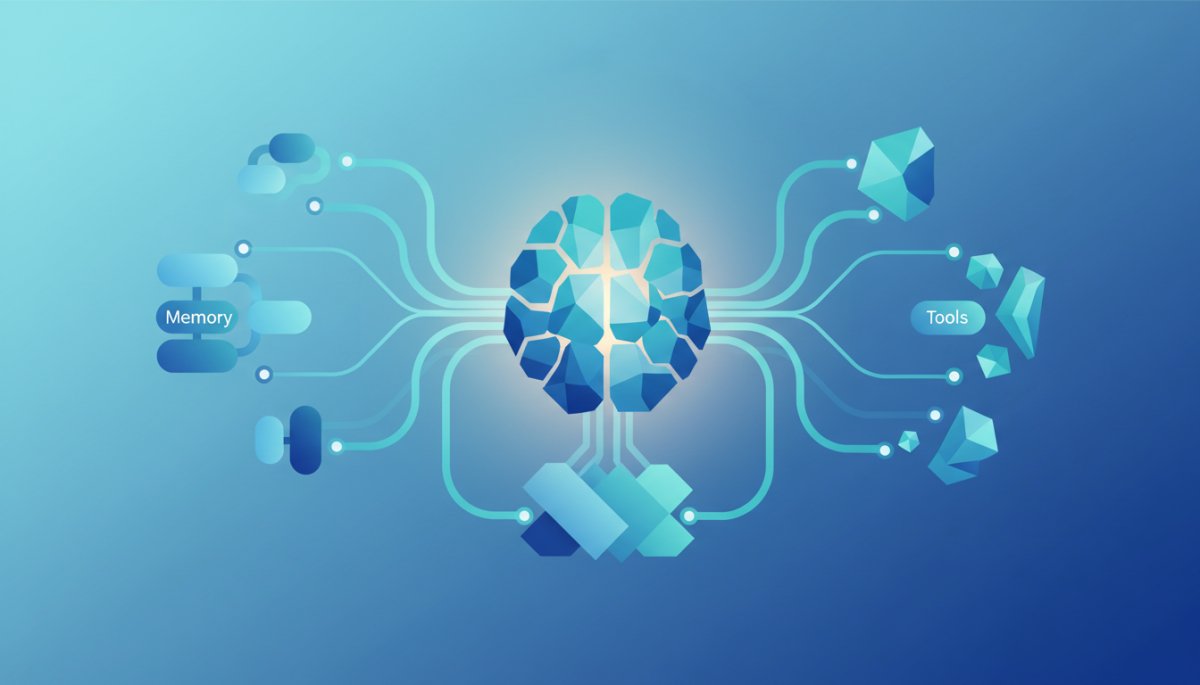
本記事は、AIエージェントの設計原則・構築手順・代表的な設計パターン・実務導入時の注意点までを体系的に扱う。プログラミング経験の有無を問わず、業務でAIエージェントを活用したいすべての方を対象としている。
目次
- 1 AIエージェント設計とは何か?従来のチャットボットとの違いは?
- 2 AIエージェントを構成する4つの要素とは何か?
- 3 AIエージェントの構築手順はどのように進めるべきか?
- 4 AIエージェントの設計パターンにはどのような種類があるか?
- 5 システムプロンプト設計で何を決めるべきか?
- 6 AIエージェント導入で業務はどう変わるか?実務ユースケースを解説
- 7 AIエージェント設計で失敗しないためのベストプラクティスとは?
- 8 AIエージェント設計を学ぶにはどこから始めるべきか?
- 9 よくある質問
- 9.1 AIエージェントとは何ですか?
- 9.2 AIエージェント設計で最初にすべきことは何ですか?
- 9.3 AIエージェントの設計パターンにはどのような種類がありますか?
- 9.4 プログラミング知識がなくてもAIエージェントは作れますか?
- 9.5 AIエージェントのメモリ設計はなぜ重要ですか?
- 9.6 マルチエージェントとシングルエージェントはどう使い分けますか?
- 9.7 AIエージェントのガードレール設計はなぜ必要ですか?
- 9.8 AIエージェント導入でどのくらいの業務削減効果が期待できますか?
- 9.9 AIエージェント設計にはどのようなツールやフレームワークが使われますか?
- 9.10 AIエージェントの設計を学ぶのに最適な方法は何ですか?
- 10 結論
AIエージェント設計とは何か?従来のチャットボットとの違いは?
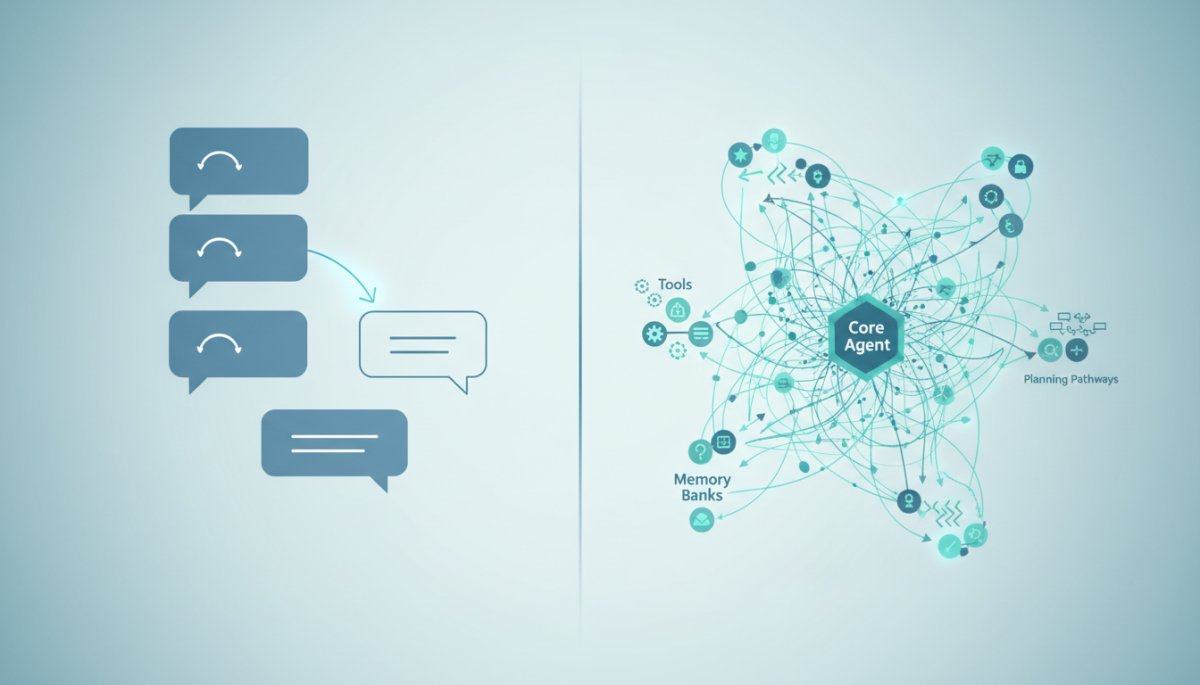
AIエージェント設計とは、LLMを中核に据え、外部ツール・メモリ・計画機構を組み合わせて「自律的に業務を完遂するシステム」を構築するプロセスである。従来のチャットボットが「1問1答」にとどまるのに対し、AIエージェントは複数ステップの業務を人間の介在なしに処理できる点が根本的な違いだ。
KDDIアイレット(2025年)の技術解説によれば、AIエージェントは次の式で表現できる。
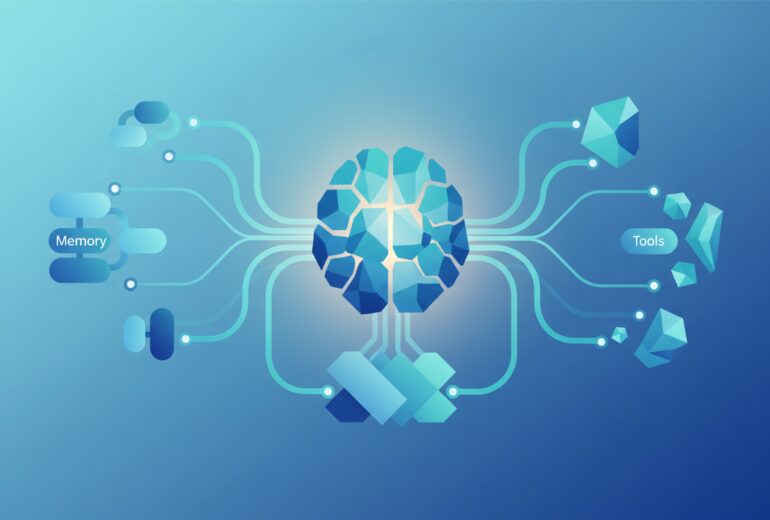
AIエージェント = LLM + メモリ + ツール + 計画機構
たとえば「顧客の注文状況を確認し、配送遅延があれば社内システムにエスカレーションする」という一連の業務を、指示なしに自律処理できるのがAIエージェントの本質である。
- 従来のチャットボット:テキスト回答のみ、単一の質問への応答、会話履歴のみ保持
- AIエージェント:外部API・データベースと連携、複数ステップの業務を連続処理、短期・長期の文脈を保持
この違いを理解することが、設計の出発点となる。「何を自動化したいのか」を問わずにツール選定から入ると、後工程のすべてがブレる。まず目的を定義することが、設計の第一原則である。
AIエージェントを構成する4つの要素とは何か?
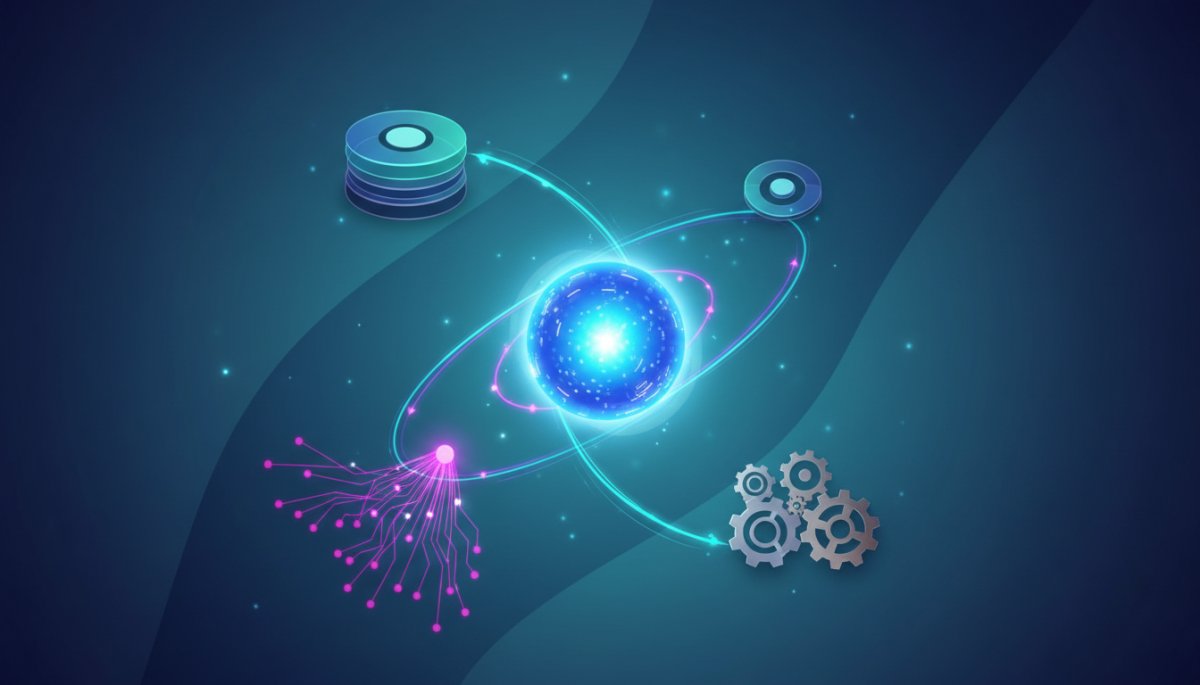
AIエージェントの設計品質は、4つの構成要素をどう組み合わせるかで決まる。それぞれの役割を正確に理解することが、目的に応じた設計の土台となる。
①LLM(大規模言語モデル):エージェントの「頭脳」
LLMはユーザーの意図を理解し、次に取るべき行動を推論する役割を担う。KDDIアイレット(2025年)によれば、Amazon BedrockではClaude(Anthropic)・Amazon Nova・Llama(Meta)など、用途に応じてモデルを選択できる。
- 推論能力:複数ステップの計画立案に強いモデルを選ぶ
- コンテキスト長:長い会話やドキュメントを扱う場合は長コンテキスト対応モデルが必要
- コスト:性能とAPIコストのトレードオフを事前に試算する
②メモリ(Memory):文脈の保持機構
メモリはエージェントが過去のやり取りや学習した情報を保持する仕組みだ。短期メモリはセッション内の会話履歴を、長期メモリはユーザーごとの設定や過去の処理結果を保持する。RAG(Retrieval-Augmented Generation)とベクターDBを組み合わせることで、LLMの知識を大幅に拡張できる。
- エピソード記憶:会話履歴の保持
- ワーキングメモリ:現在タスクの短期文脈
- ベクターDB:長期知識のセマンティック検索
- 構造化DB:SQL等で構造化情報を保存
③ツール(Tools):エージェントの「手足」
ツールはエージェントが外部システムと連携するための手段である。ツールがなければ、エージェントはただの会話AIにとどまる。LLMはFunction Calling(関数呼び出し)の仕組みを使い、必要なタイミングで適切なツールを選択・実行する。
- ローカルツール:ファイル読み書き、計算処理
- APIツール:Web検索、データベース、SaaSアプリ
- MCPサーバー:Model Context Protocolによる標準化されたツール接続
- 他のAIエージェント:マルチエージェント構成でサブタスクを委譲
④計画機構(Planning):タスク分解と実行制御
計画機構は複雑なタスクを小さなステップに分解し、実行順序を決定する仕組みだ。たとえば「週次レポートを作成する」という目標に対して、「データ取得→集計→グラフ作成→文書生成」というステップに分解して順次実行する。この機構の設計精度が、エージェント全体の完遂率を左右する。
AIエージェントの構築手順はどのように進めるべきか?
AIエージェントの構築は、目的定義から始まる8段階のプロセスで進めるのが実務上の定石である。アビームコンサルティング(日経BP、2026年3月)の実践ガイドでも、「導入プロジェクトの全体像を先に描くこと」が成功の前提として強調されている。
- 目的とスコープの定義:解決する業務課題を1つに絞り、ユーザーニーズ・成功基準・制約条件を明文化する
- システムプロンプト設計:エージェントの役割・行動規範・ガードレールを設計する
- LLMの選定:タスク要件(推論・コード生成・多言語等)に合ったモデルを選ぶ
- ツールの統合:必要な外部連携(API・DB・ファイル操作等)を定義し実装する
- メモリシステムの設計:短期・長期メモリの種類と保持範囲を決定する
- オーケストレーションの設計:ReActやプランナーなど実行制御パターンを選択する
- テストと評価:想定外の質問・エスカレーション・トーンの一貫性を検証する
- 本番運用と改善:利用ログを分析し、継続的に精度を向上させる
特に重要なのはステップ1だ。「汎用エージェントを作ろうとしない」という原則は、実務経験を持つ設計者が口を揃えて強調する点である。最初は1つのユースケースに絞ることで、後工程の設計判断がすべて明確になる。
目的定義で押さえるべき4つの問い
- ユースケース:何の問題を解決するか
- ユーザーニーズ:誰が使うのか、何を期待しているか
- 成功基準:目標達成をどう測るか(件数削減率・処理時間等)
- 制約条件:予算・法規制・技術的限界・セキュリティ要件
たとえば社内ナレッジAIチャット「ナレナビ」の導入事例では、問い合わせ件数を75%削減という明確な成功基準を設定したことが、設計の方向性を一貫させる軸になった。目標値を数値で定義することが、設計品質を高める実践的な方法である。
AIエージェントの設計パターンにはどのような種類があるか?
設計パターンの選択は、エージェントの完遂率と拡張性を決定づける。O’Reillyジャパン『実践AIエージェント開発』(2026年4月)では、シングルエージェントとマルチエージェントの2大アーキテクチャを軸に、用途別の設計パターンが体系化されている。
シングルエージェントアーキテクチャ
1つのLLMが計画・実行・評価をすべて担う構成だ。シンプルで制御しやすく、単一ドメインの業務自動化に適している。代表的なパターンは以下の通りである。
- ReActエージェント:「思考→ツール呼び出し→観察」を繰り返す。汎用性が高く、最初の実装に向いている
- リフレクションエージェント:自身の出力を評価・修正するループを持つ。精度が求められるタスクに有効
- プランナーエグゼキューターエージェント:計画フェーズと実行フェーズを分離する。複雑なワークフローに対応しやすい
マルチエージェントアーキテクチャ
複数のエージェントが協調・並列処理・調整を行う構成だ。O’Reillyジャパン『生成AIデザインパターン』(2026年5月)では、マルチエージェントコラボレーション(パターン23)として、役割分担による精度向上と処理速度の両立が解説されている。
- オーケストレーター+サブエージェント:親エージェントがタスクを分解し、専門エージェントに委譲する
- 並列処理型:独立したサブタスクを複数エージェントが同時実行し、結果を統合する
- ピアツーピア型:エージェント同士が対等に通信・協調する(ACP・MCP・A2Aプロトコルを活用)
Preferred Networks(2024年)の研究では、LLMエージェントの自動設計フレームワーク「ADAS(Automated Design of Agentic Systems)」がNeurIPS 2024 Open-World Agentic WorkshopのOutstanding Paperに選出されており、自動設計されたエージェントが従来の手動設計を上回る性能を示すケースも確認されている。設計の自動化は今後の重要なトレンドである。
システムプロンプト設計で何を決めるべきか?
システムプロンプトはエージェントの行動規範であり、設計の中核をなす。ここが曖昧だと、エージェントは期待外れの挙動を繰り返す。設計すべき4要素は明確に定義されている。
- 目標:エージェントのコアタスク(何を達成するか)
- ロール/ペルソナ:どのような立場で対話するか(例:カスタマーサポート担当)
- 指示内容:具体的な行動規範と応答スタイル(例:回答は3文以内)
- ガードレール:有害な出力や逸脱行動を防ぐ制限(例:個人情報を収集しない)
実務上の設計例として、社内FAQ対応エージェントであれば「製品に関係のない話題には答えない」「推測回答はNG」「回答できない場合はエスカレーション先を案内する」といったルールをシステムプロンプトに明記する。これにより、エージェントのトーンと品質が一貫する。
ガードレール設計の重要性
O’Reillyジャパン『生成AIデザインパターン』(2026年5月)では、セーフガードとして「テンプレート生成」「セルフチェック」「ガードレール」の3パターンが提示されている。特に本番運用では、ハルシネーション(事実と異なる出力)を防ぐリフレクション機構と組み合わせることが推奨されている。
- セルフチェック:エージェント自身が出力の妥当性を検証するループ
- 審判としてのLLM:別のLLMが出力品質を評価する二重チェック構造
- 依存性注入:外部の検証ロジックをエージェントに組み込む
ガードレールの設計は、エージェントを「使えるシステム」から「信頼できるシステム」に引き上げる工程である。特に顧客対応や社内規定検索など、誤回答のリスクが高い用途では必須の設計要素だ。
AIエージェント導入で業務はどう変わるか?実務ユースケースを解説
AIエージェントの導入効果は、ユースケースの選定精度に比例する。ROIが高く、最初の導入に最適とされるのは「ナレッジ検索」と「FAQ対応」の2領域だ。アビームコンサルティング(日経BP、2026年3月)では、財務・経理・総務部門のユースケースが具体的に紹介されており、要件定義ステップと効果の可視化方法が体系化されている。
代表的な業務ユースケース
- 社内FAQエージェント:勤怠・経費・ITトラブルなど繰り返し質問に自動対応。問い合わせ件数の大幅削減が期待できる
- ナレッジ検索エージェント:PDF・議事録・マニュアルを横断検索し、要約まで生成。情報収集時間を短縮する
- 顧客サポートエージェント:よくある問い合わせに自動で一次回答。対応品質の均一化と人的コスト削減を両立する
- 調査・レポート作成エージェント:市場調査・競合分析・業界動向を自動でレポート化する
- 業務プロセス自動化エージェント:データ取得→集計→文書生成の一連のワークフローを自律実行する
社内ナレッジAIチャット「ナレナビ」の導入事例では、問い合わせ件数を75%削減という実績が出ている。この数値は、ユースケースを「社内FAQ対応」に絞り込み、ナレッジの整備とエージェント設計を連動させた結果である。汎用的な設計ではなく、課題特化型の設計が成果を生む。
医療・材料科学分野への応用
AIエージェントの応用範囲は業務効率化にとどまらない。ZENKIGENデータサイエンスチーム(2025年5月)が紹介したサーベイ論文「From LLM Reasoning to Autonomous AI Agents」によれば、医療分野では診断支援・メンタルヘルスケア・創薬パイプラインの自動化、材料科学分野では研究ワークフローの効率化にAIエージェントが活用されている。業種を問わず、複数ステップの専門的判断が必要な領域でエージェントの価値は高まっている。
AIエージェント設計で失敗しないためのベストプラクティスとは?
AIエージェントの設計は、技術的な実装よりも「設計判断の積み重ね」で品質が決まる。実務で繰り返し確認されている失敗パターンと、それを防ぐ設計原則を整理する。
よくある失敗パターン
- 目的が曖昧なまま実装を始める:後工程のすべてがブレ、テストで問題が噴出する
- 汎用エージェントを目指す:機能が分散し、どのユースケースでも中途半端な精度になる
- ツールを増やしすぎる:LLMのツール選択精度が低下し、誤動作が増える
- メモリ設計を後回しにする:文脈の断絶が発生し、ユーザー体験が著しく低下する
- 本番前のテストが不十分:想定外の質問やエスカレーション経路の未整備が露呈する
設計品質を高める5つの原則
- 反復設計(Iterative Design):小さく始めて、ログを見ながら段階的に拡張する
- 評価戦略の事前定義:成功基準を数値で定め、テスト設計に反映する
- ツールは最小限から:必要なツールだけを定義し、動作確認後に追加する
- ガードレールを最初から組み込む:後付けでは対応しきれないリスクが残る
- コンテキストエンジニアリング:LLMに渡す情報の質と量を最適化し、推論精度を高める
O’Reillyジャパン『実践AIエージェント開発』(2026年4月)では、「性能・拡張性・信頼性・コスト」の4軸でトレードオフを明示的に設計することが、本番運用に耐えるエージェントシステムの条件として挙げられている。設計段階でこの4軸を整理しておくことが、後工程の手戻りを最小化する。
セキュリティとコスト管理
本番運用への移行時に多くの組織が直面するのが、セキュリティとコスト管理の課題だ。APIコールの頻度・モデルの選択・キャッシュ活用(プロンプトキャッシュ)を組み合わせることで、性能を維持しながらコストを抑制できる。また、エージェントが扱うデータの機密性に応じて、オンプレミス展開やアクセス制御の設計を事前に決定しておく必要がある。
AIエージェント設計を学ぶにはどこから始めるべきか?
AIエージェント設計の学習は、「概念理解→設計パターンの習得→実装体験→実務適用」の順で進めるのが最も効率的である。特に実務での活用を目指す場合、理論だけでなく「動くものを作る体験」が理解を定着させる。
学習ステップの目安
- LLMの基礎理解:プロンプトエンジニアリング・Function Calling・RAGの仕組みを把握する
- 設計パターンの習得:ReAct・リフレクション・マルチエージェントの違いを理解する
- ノーコード/ローコードツールで実装体験:DifyなどのプラットフォームでAIエージェントを実際に構築する
- コードベースの実装:LangChainやClaude Codeを使い、カスタムエージェントを開発する
- 実務への適用:自社の業務課題に合わせたエージェントを設計・運用する
AIBLポータルサイト(株式会社グレイトフルエージェント運営)では、プログラミング知識ゼロから最短2ヶ月でアプリやチャットボットを作る「バイブコーディング」eラーニングや、Claude Codeによる業務自動化人材育成研修を提供している。Proプラン(月額55,000円)ではAGIサポート(AIエージェント導入の24時間伴走支援)も利用可能で、業務整理から設計・設定・活用方法まで一貫してサポートを受けられる。
また、世界100以上のサイトから厳選したAI情報を日本語で毎日更新する「AIBLニュース」は、AIエージェントの最新動向を継続的にキャッチアップするための実践的な情報源として活用できる。フリープランから利用可能である。
AIエージェントの設計と実務導入を本格的に進めたい方は、AIBLポータルサイトの無料体験講座(平日10:00〜18:00、オンライン)から始めることをお勧めする。業務改善ネタを1つ持ち帰れる実践型の内容で、毎週木曜12:00〜12:45のAI業務効率化ミニワークショップでは、メール返信や議事録テンプレートをその場で使える形で提供している。まず体験して、自分の業務に合う設計の方向性を見つけることが、最短の学習経路である。
よくある質問
AIエージェントとは何ですか?
AIエージェントとは、LLMを中核にメモリ・ツール・計画機構を組み合わせ、目標に向けて自律的にタスクを実行するシステムである。従来のチャットボットと異なり、複数ステップの業務を人間の介在なしに処理できる。
AIエージェント設計で最初にすべきことは何ですか?
最初にすべきは「目的とスコープの定義」である。解決する業務課題を1つに絞り、ユーザーニーズ・成功基準・制約条件を明文化することが、後工程の設計判断をすべて明確にする起点となる。
AIエージェントの設計パターンにはどのような種類がありますか?
主な設計パターンはReActエージェント・リフレクションエージェント・プランナーエグゼキューターの3種(シングル構成)と、オーケストレーター+サブエージェント・並列処理型・ピアツーピア型(マルチ構成)がある。用途と複雑さに応じて選択する。
プログラミング知識がなくてもAIエージェントは作れますか?
DifyなどのノーコードプラットフォームやAIBLポータルのバイブコーディングeラーニングを活用すれば、プログラミング知識ゼロからでも最短2ヶ月でチャットボットやエージェントを構築できる。
AIエージェントのメモリ設計はなぜ重要ですか?
メモリ設計が不十分だと、会話の文脈が断絶し、ユーザーが毎回同じ説明を繰り返す必要が生じる。短期・長期メモリを適切に設計することで、精度の高い応答と一貫した対話が実現する。
マルチエージェントとシングルエージェントはどう使い分けますか?
単一ドメインの業務自動化にはシングルエージェントが適している。複数の専門領域にまたがる複雑なワークフローや、並列処理で速度を上げたい場合はマルチエージェントアーキテクチャを選択する。
AIエージェントのガードレール設計はなぜ必要ですか?
ガードレールがないと、ハルシネーション(事実と異なる出力)や意図しない情報漏洩が発生するリスクがある。顧客対応や社内規定検索など誤回答のリスクが高い用途では、セルフチェックや二重チェック機構の設計が必須である。
AIエージェント導入でどのくらいの業務削減効果が期待できますか?
社内ナレッジAIチャット「ナレナビ」の導入事例では問い合わせ件数を75%削減した実績がある。ただし効果はユースケースの選定精度と設計品質に依存するため、まず1つの課題に絞った小規模導入から始めることが推奨される。
AIエージェント設計にはどのようなツールやフレームワークが使われますか?
代表的なフレームワークはLangChain・Dify・Claude Code・Amazon Bedrockなどである。ノーコード寄りのDifyから、コードベースのLangChainまで、チームのスキルセットと要件に応じて選択する。
AIエージェントの設計を学ぶのに最適な方法は何ですか?
「概念理解→設計パターン習得→ノーコードツールでの実装体験→コードベースの実装→実務適用」の順で進めるのが最も効率的である。AIBLポータルの無料体験講座やバイブコーディングeラーニングは、実践的な学習の入口として活用できる。
結論
AIエージェント設計の成否は、「目的の明確化」と「4要素(LLM・メモリ・ツール・計画機構)の適切な組み合わせ」で決まる。汎用エージェントを目指さず、まず1つの業務課題に絞って小さく始めることが最短の成功経路である。設計パターン・ガードレール・反復改善の3点を設計段階から組み込むことで、本番運用に耐えるエージェントが構築できる。学習と実践を並行させたい場合は、AIBLポータルの無料体験講座から始めることを勧める。


コメント