本記事は、AIエージェントの設計原則・構築手順・代表的な設計パターン・実務導入時の注意点までを体系的に扱う。プログラミング経験の有無を問わず、業務でAIエージェントを活用したいすべての方を対象としている。
AIエージェント設計とは何か?従来のチャットボットとの違いは?
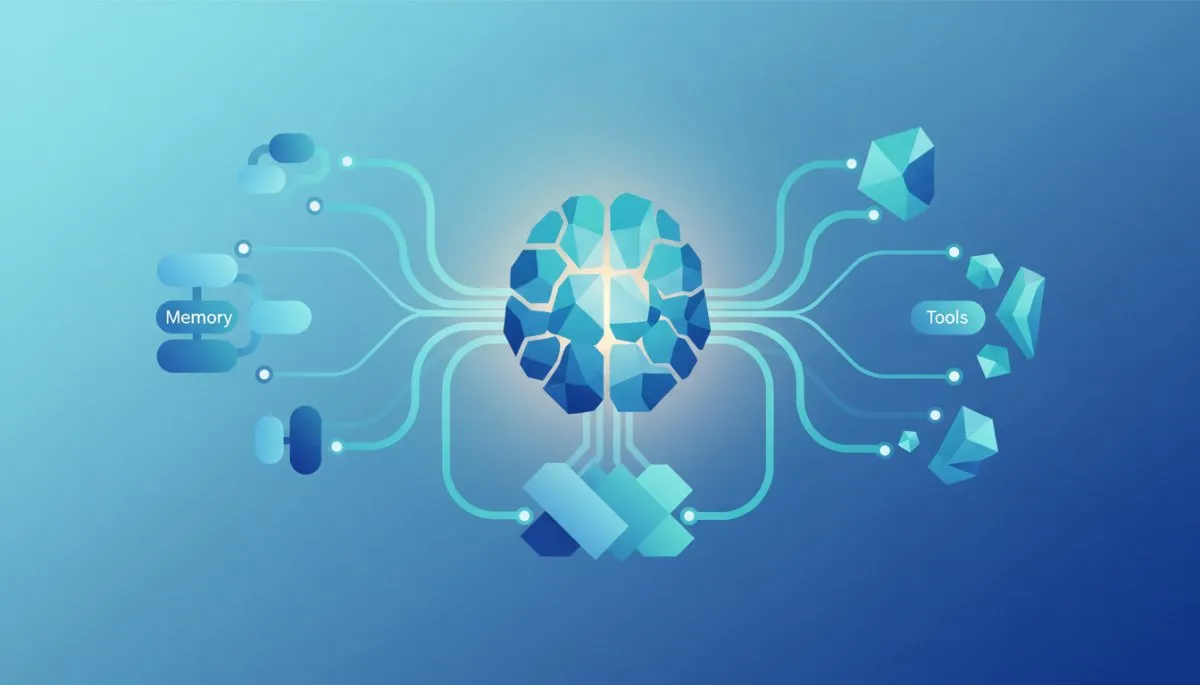
AIエージェント設計とは、LLMを中核に据え、外部ツール・メモリ・計画機構を組み合わせて「自律的に業務を完遂するシステム」を構築するプロセスである。AIエージェントは、外部ツールを使いながら複数ステップの処理を進める構成を取れる。自動化する範囲と人間が確認するタイミングを、業務に応じて設計することが重要だ(Anthropicの設計解説)。
モデル・メモリ・ツール・計画機構は、AIエージェントの構成を理解するための整理である(Google Cloudの用語解説)。本記事では、これらを次のように表す。
AIエージェント = LLM + メモリ + ツール + 計画機構
たとえば、注文状況を確認して配送遅延を担当者に通知する処理を、ツール連携によって組み立てられる。ただし、実行できる操作は接続先の権限や設定に依存する。返金や契約変更などは、人間の承認を入れる設計が考えられる。
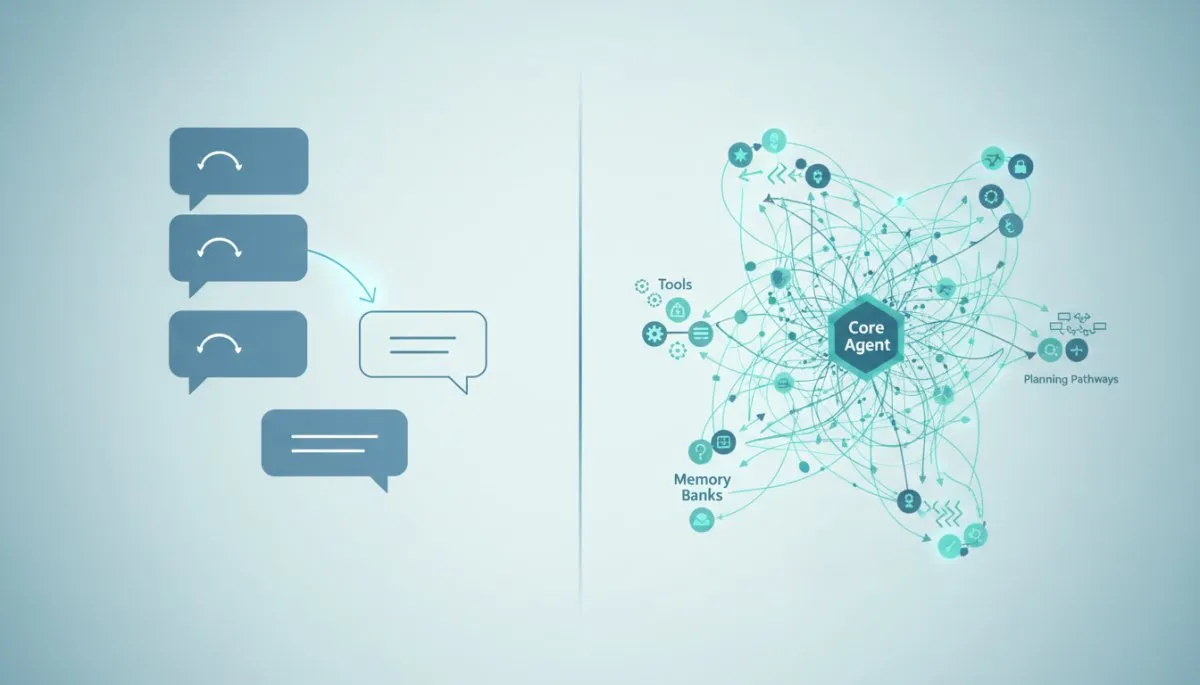
- 従来のチャットボット:テキスト回答のみ、単一の質問への応答、会話履歴のみ保持
- AIエージェント:外部API・データベースと連携、複数ステップの業務を連続処理、短期・長期の文脈を保持
この違いを理解することが、設計の出発点となる。「何を自動化したいのか」を問わずにツール選定から入ると、後工程のすべてがブレる。まず目的を定義することが、設計の第一原則である。
AIエージェントを構成する4つの要素とは何か?
AIエージェントの設計品質は、4つの構成要素をどう組み合わせるかで決まる。それぞれの役割を正確に理解することが、目的に応じた設計の土台となる。
①LLM(大規模言語モデル):エージェントの「頭脳」
LLMは、入力された指示や情報をもとに応答や次の処理を生成する。Amazon Bedrockで利用できるモデルや対応機能は、AWSの公式モデル一覧で確認する。利用リージョンや用途に合うモデルか、実際の評価データで比較したい。
- 推論能力:複数ステップの計画立案に強いモデルを選ぶ
- コンテキスト長:長い会話やドキュメントを扱う場合は長コンテキスト対応モデルが必要
- コスト:性能とAPIコストのトレードオフを事前に試算する
②メモリ(Memory):文脈の保持機構
メモリはエージェントが過去のやり取りや学習した情報を保持する仕組みだ。短期メモリはセッション内の会話履歴を、長期メモリはユーザーごとの設定や過去の処理結果を保持する。RAG(Retrieval-Augmented Generation)とベクターDBを組み合わせることで、LLMの知識を大幅に拡張できる。
- エピソード記憶:会話履歴の保持
- ワーキングメモリ:現在タスクの短期文脈
- ベクターDB:長期知識のセマンティック検索
- 構造化DB:SQL等で構造化情報を保存
③ツール(Tools):エージェントの「手足」
ツールはエージェントが外部システムと連携するための手段である。ツールがなければ、エージェントはただの会話AIにとどまる。LLMはFunction Calling(関数呼び出し)の仕組みを使い、必要なタイミングで適切なツールを選択・実行する。
- ローカルツール:ファイル読み書き、計算処理
- APIツール:Web検索、データベース、SaaSアプリ
- MCPサーバー:Model Context Protocolによる標準化されたツール接続
- 他のAIエージェント:マルチエージェント構成でサブタスクを委譲
④計画機構(Planning):タスク分解と実行制御
計画機構は複雑なタスクを小さなステップに分解し、実行順序を決定する仕組みだ。たとえば「週次レポートを作成する」という目標に対して、「データ取得→集計→グラフ作成→文書生成」というステップに分解して順次実行する。この機構の設計精度が、エージェント全体の完遂率を左右する。
AIエージェントの構築手順はどのように進めるべきか?
本記事では、目的定義から本番運用までを8つの工程に分けて整理する。固定の標準手順ではなく、対象業務やリスクに応じて工程を追加・反復するための検討例である。
- 目的とスコープの定義:解決する業務課題を1つに絞り、ユーザーニーズ・成功基準・制約条件を明文化する
- システムプロンプト設計:エージェントの役割・行動規範・ガードレールを設計する
- LLMの選定:タスク要件(推論・コード生成・多言語等)に合ったモデルを選ぶ
- ツールの統合:必要な外部連携(API・DB・ファイル操作等)を定義し実装する
- メモリシステムの設計:短期・長期メモリの種類と保持範囲を決定する
- オーケストレーションの設計:ReActやプランナーなど実行制御パターンを選択する
- テストと評価:想定外の質問・エスカレーション・トーンの一貫性を検証する
- 本番運用と改善:利用ログを分析し、継続的に精度を向上させる
最初に、対象業務と実行してよい操作を絞る。例えば「社内規定の検索結果を示す」までに限定し、申請の承認や規定の書き換えは対象外とする。境界を先に決めると、必要なデータと評価項目を整理しやすい。
目的定義で押さえるべき4つの問い
- ユースケース:何の問題を解決するか
- ユーザーニーズ:誰が使うのか、何を期待しているか
- 成功基準:目標達成をどう測るか(件数削減率・処理時間等)
- 制約条件:予算・法規制・技術的限界・セキュリティ要件
社内FAQ対応なら、導入前後で問い合わせ件数、正答率、有人対応への引き継ぎ率、利用者が解決するまでの時間を比較する。同じ対象業務・集計期間・母数で評価し、件数だけが減って誤回答が増えていないかも確かめる。これは評価方法の例であり、特定の削減率を保証するものではない。
AIエージェントの設計パターンにはどのような種類があるか?
本記事では、実行主体が1つの構成と、役割を分けた複数の構成に分けて説明する。最初はシンプルな構成で評価し、必要性を確認してから役割分担を増やす。判断の参考として、Anthropicの設計パターン解説も参照できる。
シングルエージェントアーキテクチャ
1つのLLMが計画・実行・評価をすべて担う構成だ。シンプルで制御しやすく、単一ドメインの業務自動化に適している。代表的なパターンは以下の通りである。
- ReActエージェント:「思考→ツール呼び出し→観察」を繰り返す。汎用性が高く、最初の実装に向いている
- リフレクションエージェント:自身の出力を評価・修正するループを持つ。精度が求められるタスクに有効
- プランナーエグゼキューターエージェント:計画フェーズと実行フェーズを分離する。複雑なワークフローに対応しやすい
マルチエージェントアーキテクチャ
複数のエージェントに、調査・作成・確認などの役割を分担させる構成である。並列化できる作業があるか、情報の受け渡しや失敗時の処理を管理できるかを確認する。複数化によって精度や速度が必ず上がるわけではなく、通信回数や費用も評価する。
- オーケストレーター+サブエージェント:親エージェントがタスクを分解し、専門エージェントに委譲する
- 並列処理型:独立したサブタスクを複数エージェントが同時実行し、結果を統合する
- ピアツーピア型:エージェント同士で情報を受け渡して処理を進める。役割分担、通信方法、停止条件を事前に決める
担当が変わっても必要な情報を引き継げるように、各エージェントへ渡す資料、処理結果、残りの作業を決めておく。情報量を増やすだけでなく、次の判断に必要な文脈を選ぶという観点では、Anthropicのコンテキスト設計解説が参考になる。
システムプロンプト設計で何を決めるべきか?
システムプロンプトはエージェントの行動規範であり、設計の中核をなす。ここが曖昧だと、エージェントは期待外れの挙動を繰り返す。設計すべき4要素は明確に定義されている。
- 目標:エージェントのコアタスク(何を達成するか)
- ロール/ペルソナ:どのような立場で対話するか(例:カスタマーサポート担当)
- 指示内容:具体的な行動規範と応答スタイル(例:回答は3文以内)
- ガードレール:有害な出力や逸脱行動を防ぐ制限(例:個人情報を収集しない)
実務上の設計例として、社内FAQ対応エージェントであれば「製品に関係のない話題には答えない」「推測回答はNG」「回答できない場合はエスカレーション先を案内する」といったルールをシステムプロンプトに明記する。これにより、エージェントのトーンと品質が一貫する。
ガードレール設計の重要性
ガードレールでは、入力・出力の確認に加え、使えるデータと実行できる操作を制限する。モデル自身の再確認だけに頼らず、アクセス権、ルールによる検査、人間への引き継ぎも組み合わせる。生成AIのリスク管理の参考として、NISTの生成AIプロファイルを挙げる。
- セルフチェック:エージェント自身が出力の妥当性を検証するループ
- 審判としてのLLM:別のLLMが出力品質を評価する二重チェック構造
- 依存性注入:外部の検証ロジックをエージェントに組み込む
ガードレールの設計は、エージェントを「使えるシステム」から「信頼できるシステム」に引き上げる工程である。特に顧客対応や社内規定検索など、誤回答のリスクが高い用途では必須の設計要素だ。
AIエージェント導入で業務はどう変わるか?実務ユースケースを解説
社内FAQやナレッジ検索は、小さく検証する用途の例である。必要な資料が整っているか、回答を確認する担当者を置けるか、失敗時に人へ戻せるかを確認して対象業務を選ぶ。業務量やデータの状態によって費用対効果は変わる。
代表的な業務ユースケース
- 社内FAQエージェント:勤怠・経費・ITトラブルなど繰り返し質問に自動対応。問い合わせ件数の大幅削減が期待できる
- ナレッジ検索エージェント:PDF・議事録・マニュアルを横断検索し、要約まで生成。情報収集時間を短縮する
- 顧客サポートエージェント:よくある問い合わせに自動で一次回答。対応品質の均一化と人的コスト削減を両立する
- 調査・レポート作成エージェント:市場調査・競合分析・業界動向を自動でレポート化する
- 業務プロセス自動化エージェント:データ取得→集計→文書生成の一連のワークフローを自律実行する
例えば社内FAQでは、対象の規定・マニュアルを整理し、回答に参照先を付け、回答できない場合は担当者へ引き継ぐ。導入前に測定項目を決めて小規模に試し、結果を確認してから対象を広げる。
医療・材料科学分野への応用
専門性の高い領域では、出力内容を確認できる担当者と、利用できるデータの範囲を先に決める。生成AIの出力をそのまま確定判断に使うのではなく、業務のリスクに応じた検証や承認を組み込む(NISTの生成AIリスク管理資料)。
AIエージェント設計で失敗しないためのベストプラクティスとは?
AIエージェントの設計は、技術的な実装よりも「設計判断の積み重ね」で品質が決まる。実務で繰り返し確認されている失敗パターンと、それを防ぐ設計原則を整理する。
よくある失敗パターン
- 目的が曖昧なまま実装を始める:後工程のすべてがブレ、テストで問題が噴出する
- 汎用エージェントを目指す:機能が分散し、どのユースケースでも中途半端な精度になる
- ツールを増やしすぎる:LLMのツール選択精度が低下し、誤動作が増える
- メモリ設計を後回しにする:文脈の断絶が発生し、ユーザー体験が著しく低下する
- 本番前のテストが不十分:想定外の質問やエスカレーション経路の未整備が露呈する
設計品質を高める5つの原則
- 反復設計(Iterative Design):小さく始めて、ログを見ながら段階的に拡張する
- 評価戦略の事前定義:成功基準を数値で定め、テスト設計に反映する
- ツールは最小限から:必要なツールだけを定義し、動作確認後に追加する
- ガードレールを最初から組み込む:後付けでは対応しきれないリスクが残る
- コンテキストエンジニアリング:LLMに渡す情報の質と量を最適化し、推論精度を高める
設計時の確認項目として、回答品質、処理時間、運用費用、権限管理、障害時の対応を挙げる。どれを優先するかを決め、テスト結果と利用ログを見て構成を見直す。単一の評価指標だけで本番運用の可否を決めない。
セキュリティとコスト管理
本番運用への移行時に多くの組織が直面するのが、セキュリティとコスト管理の課題だ。APIコールの頻度・モデルの選択・キャッシュ活用(プロンプトキャッシュ)を組み合わせることで、性能を維持しながらコストを抑制できる。また、エージェントが扱うデータの機密性に応じて、オンプレミス展開やアクセス制御の設計を事前に決定しておく必要がある。
AIエージェント設計を学ぶにはどこから始めるべきか?
AIエージェント設計の学習は、「概念理解→設計パターンの習得→実装体験→実務適用」の順で進めるのが最も効率的である。特に実務での活用を目指す場合、理論だけでなく「動くものを作る体験」が理解を定着させる。
学習ステップの目安
- LLMの基礎理解:プロンプトエンジニアリング・Function Calling・RAGの仕組みを把握する
- 設計パターンの習得:ReAct・リフレクション・マルチエージェントの違いを理解する
- ノーコード/ローコードツールで実装体験:DifyなどのプラットフォームでAIエージェントを実際に構築する
- コードベースの実装:LangChainやClaude Codeを使い、カスタムエージェントを開発する
- 実務への適用:自社の業務課題に合わせたエージェントを設計・運用する
AIBLポータルサイト(株式会社グレイトフルエージェント運営)では、eラーニングやライブ研修、バイブコーディングのチャット相談など、AIを学び実践するためのメニューを提供している。Proプランは月額55,000円(税込)で、最低契約期間は1年。AGI(AIエージェント)導入サポートでは、業務に合わせたAIの設計・設定・活用を支援する。利用できる内容と契約条件は、申込前に公式料金ページで確認してほしい。
最新情報を追う際は、利用している製品の公式ドキュメントや更新情報を確認する。サービス紹介やニュースの要約だけで判断せず、実装する機能の提供条件や制約を原典で確かめる。
AIBLの学習メニューや相談窓口を利用する際は、公式サイトで現在の提供内容と開催案内を確認してほしい。自社で試したい業務を1つ用意し、必要な権限や実装範囲を相談すると、学習と業務適用を結び付けやすい。
よくある質問
AIエージェントとは何ですか?
AIエージェントは、LLMが外部ツールを利用しながら複数の処理を進める構成である。実行範囲は与えた権限や設定に依存し、重要な操作には人間の承認を組み込める。
AIエージェント設計で最初にすべきことは何ですか?
最初にすべきは「目的とスコープの定義」である。解決する業務課題を1つに絞り、ユーザーニーズ・成功基準・制約条件を明文化することが、後工程の設計判断をすべて明確にする起点となる。
AIエージェントの設計パターンにはどのような種類がありますか?
主な設計パターンはReActエージェント・リフレクションエージェント・プランナーエグゼキューターの3種(シングル構成)と、オーケストレーター+サブエージェント・並列処理型・ピアツーピア型(マルチ構成)がある。用途と複雑さに応じて選択する。
プログラミング知識がなくてもAIエージェントは作れますか?
Difyなどのツールでは画面上でエージェントの処理を組み立てられる(Dify公式ドキュメント)。ただし、外部サービスの認証、権限設定、動作確認は必要で、習得期間は経験や実装範囲によって異なる。
AIエージェントのメモリ設計はなぜ重要ですか?
メモリ設計が不十分だと、会話の文脈が断絶し、ユーザーが毎回同じ説明を繰り返す必要が生じる。短期・長期メモリを適切に設計することで、精度の高い応答と一貫した対話が実現する。
マルチエージェントとシングルエージェントはどう使い分けますか?
単一ドメインの業務自動化にはシングルエージェントが適している。複数の専門領域にまたがる複雑なワークフローや、並列処理で速度を上げたい場合はマルチエージェントアーキテクチャを選択する。
AIエージェントのガードレール設計はなぜ必要ですか?
ガードレールがないと、ハルシネーション(事実と異なる出力)や意図しない情報漏洩が発生するリスクがある。顧客対応や社内規定検索など誤回答のリスクが高い用途では、セルフチェックや二重チェック機構の設計が必須である。
AIエージェント導入でどのくらいの業務削減効果が期待できますか?
一律の削減率は示せない。導入前の件数と作業時間を測り、対象範囲を限定して試行したうえで、回答の正確性、有人対応率、運用費用を含めて比較する。効果を確認できた範囲から展開する。
AIエージェント設計にはどのようなツールやフレームワークが使われますか?
利用する仕組みは、画面で処理を組むツール、コードで処理を組むライブラリ、モデルを利用する基盤などに分かれる。同じ種類の製品として扱わず、接続先、権限管理、運用方法、費用を確認して選ぶ。
AIエージェントの設計を学ぶのに最適な方法は何ですか?
「概念理解→設計パターン習得→ノーコードツールでの実装体験→コードベースの実装→実務適用」の順で進めるのが最も効率的である。AIBLポータルの無料体験講座やバイブコーディングeラーニングは、実践的な学習の入口として活用できる。
結論
AIエージェント設計の成否は、「目的の明確化」と「4要素(LLM・メモリ・ツール・計画機構)の適切な組み合わせ」で決まる。汎用エージェントを目指さず、まず1つの業務課題に絞って小さく始めることが最短の成功経路である。設計パターン・ガードレール・反復改善の3点を設計段階から組み込むことで、本番運用に耐えるエージェントが構築できる。学習と実践を並行させたい場合は、AIBLポータルの無料体験講座から始めることを勧める。
出典・参考情報
- Anthropic「Building effective agents」:2024年12月19日公開。参照日:2026年10月15日。
- Anthropic「Effective context engineering for AI agents」:2025年9月29日公開。参照日:2026年10月15日。
- AWS「Supported foundation models in Amazon Bedrock」:公開日記載なし(随時更新)。参照日:2026年10月15日。
- Dify「Agent」公式ドキュメント:公開日記載なし(随時更新)。参照日:2026年10月15日。
- NIST「Generative Artificial Intelligence Profile(NIST AI 600-1)」:2024年7月26日公開。参照日:2026年10月15日。
- Google Cloud「生成 AI の用語集」:公開日記載なし(随時更新)。参照日:2026年10月15日。
- AIBL公式料金ページ:公開日記載なし(料金・提供内容は随時更新)。参照日:2026年10月15日。
選び方・比較の目安
以下は選択の目安です。効果や費用を一律に保証するものではありません。
| 構成 | 合う処理・向かない処理 | 費用・運用の確認 |
|---|---|---|
| 単発のLLM呼び出し | 一度の入力と出力で済む要約など。複雑な外部操作は対象外 | モデル利用料と出力確認の時間 |
| 固定ワークフロー | 処理手順を事前に決められる業務。例外は別途設計 | 開発・接続・実行回数・保守の費用 |
| AIエージェント | 状況に応じてツールや手順を選ぶ必要がある業務 | 反復回数の上限、権限、停止条件、人の承認を設計。固定手順より複雑さが増える |